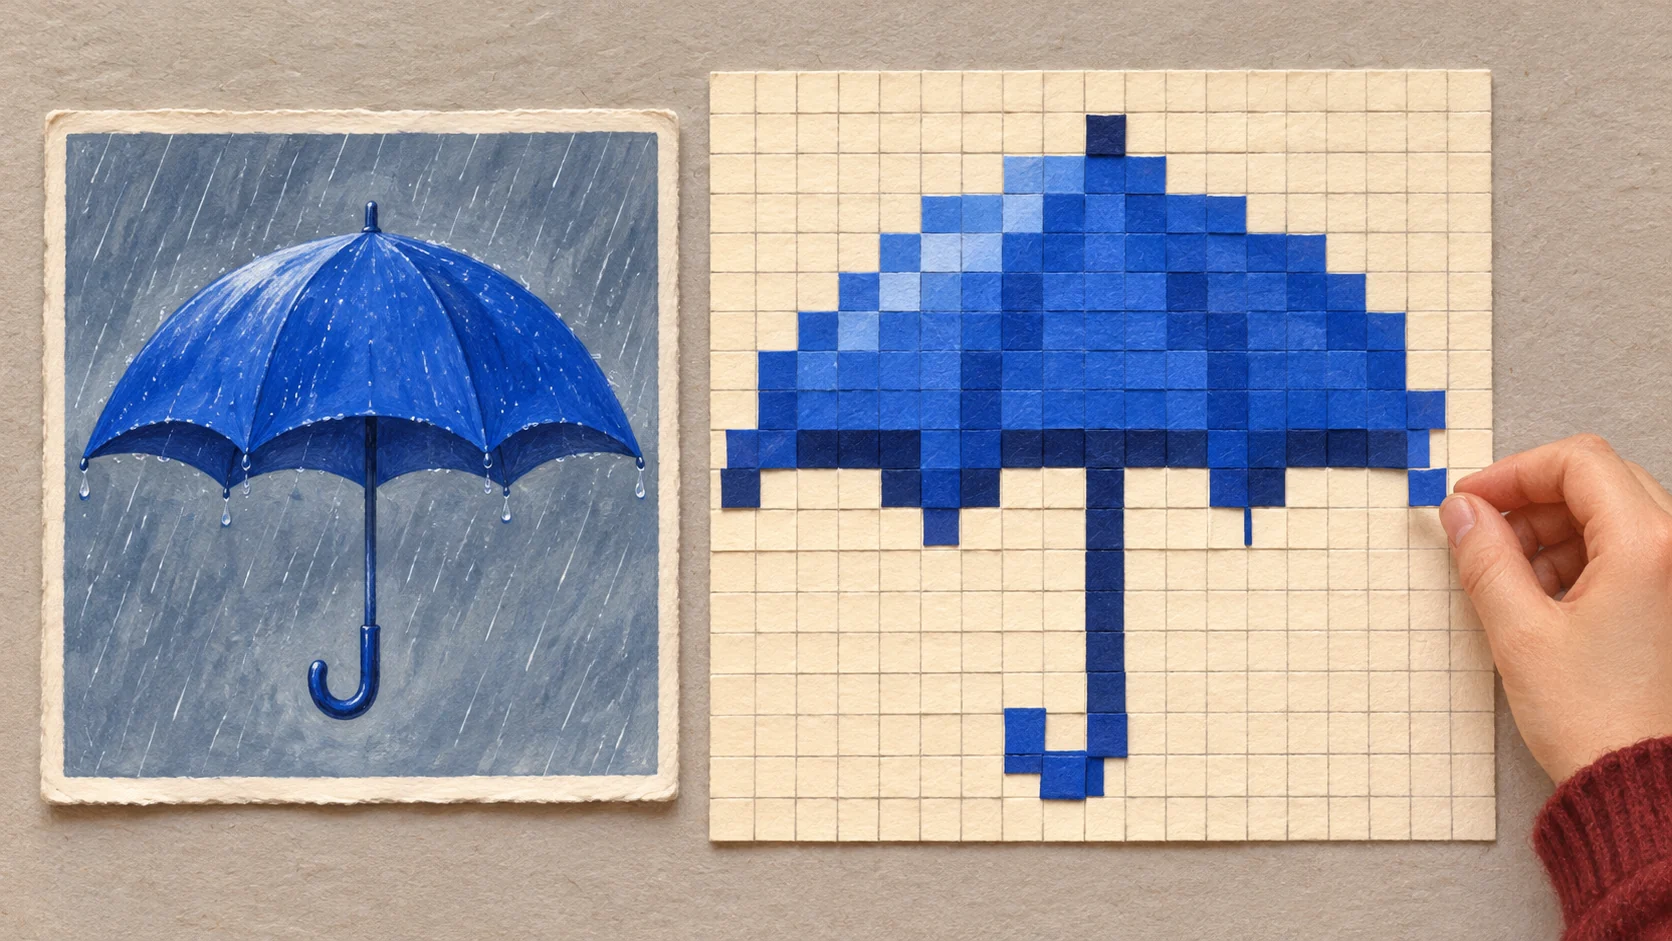
Представьте, что вы учите модель классификации изображений отличать зонты от шляп. Первые фотографии зонтов сняты в дождливую погоду, а первые фотографии шляп — в помещении. На этих учебных снимках модель, кажется, распознаёт всё отлично. А если взять другую фотографию и поставить тот же зонт в комнате — узнает ли она его?
Тут стоит спросить: модель действительно выучила форму зонта или просто воспользовалась фоном? «Лаборатория AI-магии» начинает с того, какую информацию об изображении получает машина, а затем задаёт тот же вопрос применительно к генерируемому контенту, действиям агентов и проверке человеком.
Как машина видит зонт
Если увеличить фотографию возле кончика зонта, вы увидите отдельные цветные участки. Синяя ткань зонта на снимке в обычном представлении RGB может храниться в виде сетки чисел, где каждая ячейка записывает информацию о трёх каналах — красном, зелёном и синем. Урок 1 сначала рассказывает о пикселях и цвете, а затем о том, как компьютерное зрение ищет в изображении формы и текстуры. Урок 2 organising эти числа в тензоры и обсуждает, зачем упорядочивать данные перед подачей в модель. Урок 1 «Цифровой глаз машины» · Урок 2 «Базовая единица данных (тензор)»
Можно сделать небольшое упражнение на клетчатой бумаге. Сначала нарисуйте зонт, а затем перерисуйте его на фоне другого цвета. Какие клетки изменились? Какие контуры сохранились? Человек с первого взгляда отнесёт оба рисунка к одному классу; сможет ли машина — зависит от того, как она учится на примерах.
Новая фотография, которой она ещё не видела
Урок 3 начинается с размеченных примеров, а также рассказывает о переобучении и обобщении. Переобученная модель слишком сильно опирается на детали обучающих примеров и легко ошибается на другой подборке изображений. Чтобы понять, справляется ли модель с новыми ситуациями, нужно отложить примеры, которых она не видела при обучении, и проверить её на них. Урок 3 «Мастер классификации»
Вернёмся к тому самому зонту: можно сначала подготовить фотографии шляп и зонтов на фоне помещения и на улице, а ещё одну группу отложить для теста. Если окажется, что модель всегда принимает зонт в помещении за шляпу, на следующем этапе стоит проверить, не связан ли фон в обучающих примерах слишком тесно с классом. Одна ошибка распознавания даёт подсказку, что проверять дальше.
От распознавания изображений к их генерации и действиям
Распознать фотографию зонта и сгенерировать новое изображение зонта — две разные задачи. Урок 6 объясняет процесс генерации с помощью диффузионных моделей: отправляясь от шума, шаг за шагом убирая шум, получают изображение, отвечающее заданным условиям. Урок 7 переносит вопрос на действия. Агент собирает информацию об окружающей среде, выбирает действие и выполняет его, а после действия снова наблюдает, как изменилась среда. Например, при прохождении лабиринта на бумаге по правилам на каждом шаге нужно заново определять текущее положение. Урок 6 «Генеративное искусство и диффузионные модели» · Урок 7 «Основной цикл агента»
Прежде чем доверять результату, найдите способ его проверить
Последний урок посвящён предвзятости данных, галлюцинациям моделей и человеческому надзору. Хороший вопрос для занятия: если результат ошибочен, с помощью чего я смогу это обнаружить? Для классификации изображений можно взять фотографию с совершенно другим фоном. Для сгенерированного ответа — вернуться к исходным материалам и поискать доказательства. А для системы, которая совершает действия, стоит подумать, на каком шаге человек должен подтвердить результат. Урок 10 «Этика, предвзятость и сосуществование человека и машины»
Курс рассчитан на учащихся средней школы и подойдёт также родителям и учителям, которые хотят вместе с детьми понять основы работы ИИ. Можно начать с первого урока курса на упрощённом китайском и небольших заданий на страницах, сначала разложив знакомую фотографию на пиксели, а затем подумать: какую фотографию взять для проверки в следующий раз? Перейти к AI004 «Лаборатория AI-магии»