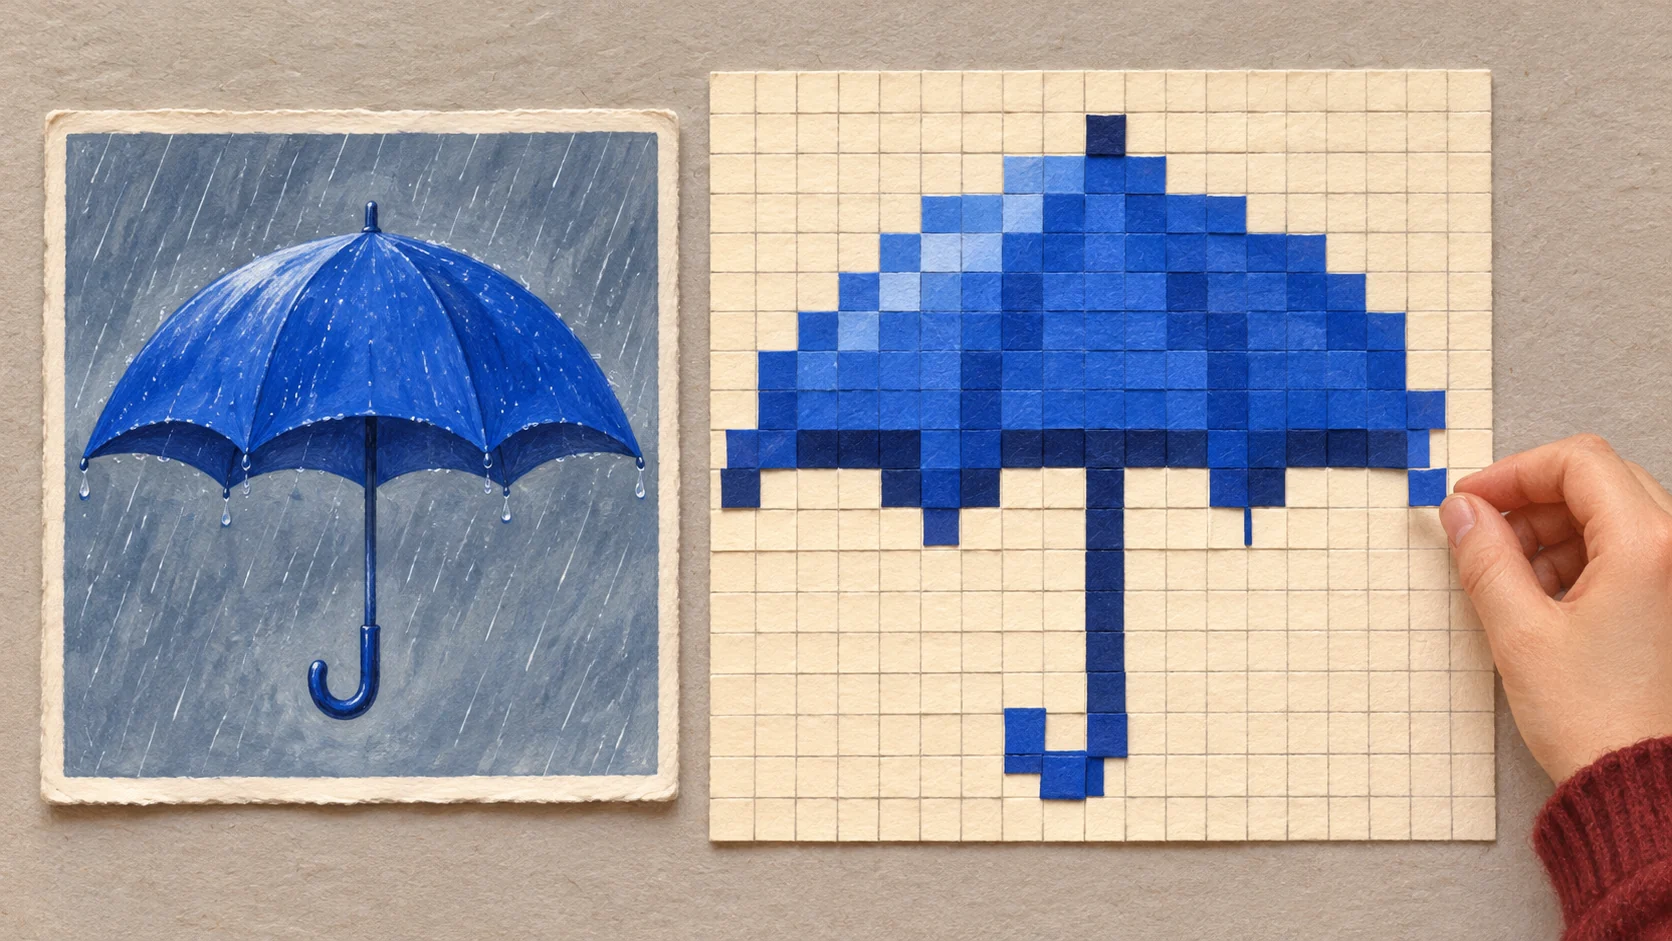
画像分類モデルに傘と帽子を見分けさせるとします。最初の傘の写真はすべて雨の日に撮られ、最初の帽子の写真はすべて室内で撮られていたとします。この訓練用の写真に対して判断させると、モデルはよく見分けられているように見えます。では、写真を一枚入れ替えて、同じ傘を室内に置いたら、それでも見分けられるでしょうか。
ここで問うべきなのは、モデルが本当に傘の形を学んだのか、それとも背景を都合よく利用しただけなのか、ということです。『AI魔法実験室』は、機械が受け取る画像情報から話を始め、同じ問いを生成コンテンツ、エージェントの行動、そして人による確認へと広げていきます。
機械はどうやって傘を見るのか
傘の先端付近の写真を拡大すると、色のブロックが見えてきます。写真の中の青い傘の面は、一般的なRGB表現ではマス目状の数値として保存でき、各マスが赤・緑・青の三つのチャンネルの情報を記録します。第1課ではまずピクセルと色を扱い、続いてコンピュータービジョンが画像からどのように形やテクスチャを探すのかを紹介します。第2課ではこれらの数値をテンソルとしてまとめ、モデルに入れる前にデータを整える必要がある理由を考えます。第1課「機械のデジタルな目」 · 第2課「データの基本単位(テンソル)」
方眼紙で小さな練習をしてみましょう。まず傘を描き、次に別の背景色で描き直します。どのマスが変わったでしょうか。どの輪郭は残っているでしょうか。人はひと目で二枚の絵を同じ種類だと認識できますが、機械にそれができるかどうかは、サンプルからどのように学ぶかによって決まります。
一度も見たことのない写真に置き換える
第3課はラベル付きのサンプルから始まり、過学習と汎化についても扱います。過学習したモデルは訓練サンプルの細部に過度に依存し、別の画像群に変えると失敗しやすくなります。モデルが新しい状況に対応できるかどうかを判断するには、訓練時に見せていないサンプルを残して確認する必要があります。第3課「分類の達人」
あの傘の話に戻りましょう。まず室内と室外の二種類の背景で撮った帽子と傘の写真を用意し、さらに別の組をテスト用に残しておきます。モデルがいつも室内の傘を帽子と認識するなら、次の段階では、訓練サンプルの中で背景がカテゴリーと結びつきすぎていないかを調べられます。一度の誤認識は、次に調べるべき手がかりを与えてくれます。
画像を見分けることから、画像を生成し、行動することへ
傘の写真を認識することと、新しい傘の画像を生成することは、二つの異なるタスクです。第6課では拡散モデルを使って生成の過程を解説し、ノイズから出発して徐々にノイズを取り除き、条件に合う画像を形作る流れを扱います。第7課では問題を行動へと広げます。エージェントは環境の情報を集め、行動を選んで実行し、行動の後に環境がどう変化したかを観察します。たとえばルールに従って紙の迷路を進むなら、一歩進むたびに現在位置を判断し直す必要があります。第6課「生成アートと拡散モデル」 · 第7課「エージェントの中核ループ」
結果を信じる前に、確認する方法を一つ見つける
最後の課では、データの偏り、モデルのハルシネーション、人による監督を扱います。教室に持っていくのに適した問いは、もし結果が間違っていたら、何を使ってそれを見つけられるだろうか というものです。画像分類なら、背景がまったく異なる写真を探せます。生成された回答なら、元の資料に戻って根拠を探せます。行動するシステムなら、どの段階を人が確認すべきかも考えられます。第10課「倫理、偏り、人と機械の共生」
このコースは中学校段階の学習者を対象としており、AIの基本原理を子どもと一緒に理解したい保護者や教師にも適しています。簡体字中国語の教材の第1課と、各ページに添えられた小問から始めて、まず見慣れた写真をピクセルに分解し、そのうえで次のテストにはどんな写真を使うべきかを考えてみましょう。AI004「AI魔法実験室」に入る