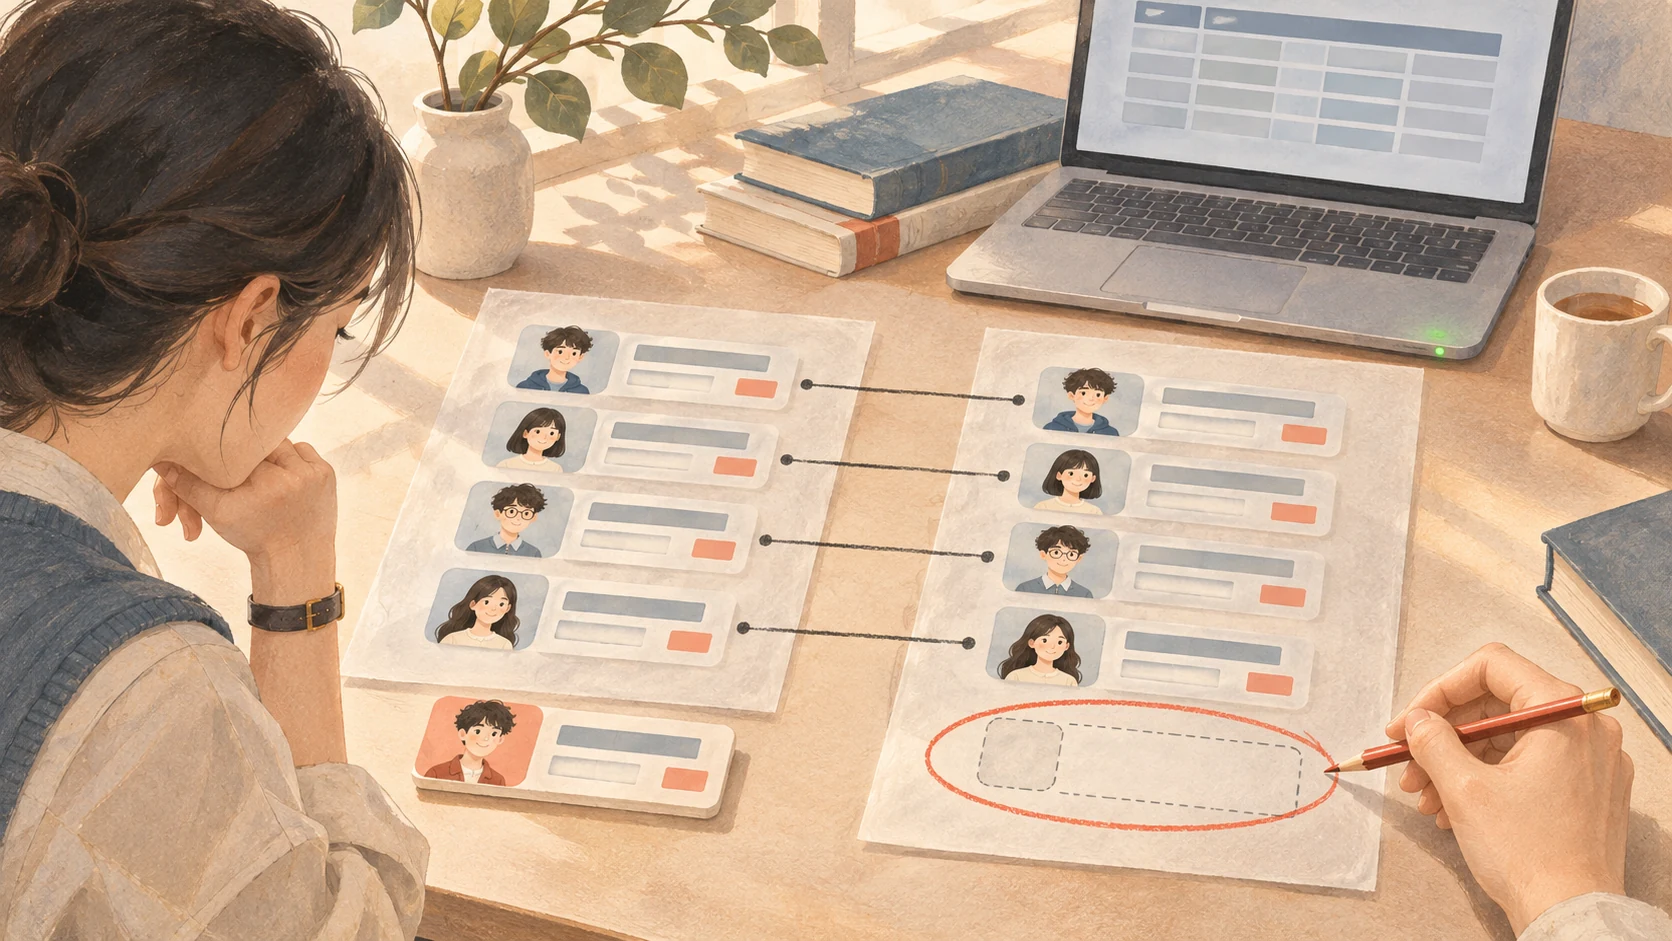
Представьте учебную ситуацию: вы хотите найти студентов, которые ещё не сдали работу, и просите AI написать для этого SQL. Программа выполняется без сбоев, на экране появляется аккуратный список.
Ошибок нет, названия столбцов совпадают. Вы уже готовы отправить напоминание, но замечаете, что студент, у которого вообще нет записи о сдаче, в результатах отсутствует.
Проблема может скрываться в способе соединения. Запрос сохранил только те записи, которые совпали в обеих таблицах, — и «человек, у которого пока нет записи», оказался исключён с самого начала.
Такие ошибки тихие. База данных выполнила именно то, что вы написали; проверить нужно другое — выражают ли эти операции то, что вы имели в виду.
Курс DSAI2202 «Database Principles» (Принципы баз данных) в Гонконгском политехническом университете охватывает моделирование данных, SQL, управление транзакциями и безопасность баз данных. Если прийти на курс с вопросом «почему в результате на одного человека меньше», у абстрактных понятий появляется след, по которому можно идти. Официальное описание курса PolyU
Его нет в списке — потому что нет записи, или потому что нет человека?
Сначала уменьшим пример из начала статьи.
В таблице студентов три человека: А Мин, Сяо Синь и А Цзе. В таблице сдач есть записи только у А Мина и Сяо Синь; А Цзе работу ещё не сдал.
Если сначала соединить две таблицы внутренним соединением, а затем искать «не сдавших», А Цзе уже не окажется в промежуточном результате. Как бы тщательно вы ни фильтровали дальше, человека, исключённого ранее, вернуть не получится.
Один из подходов — начать с полного списка студентов, сохранить каждого студента и затем проверить, существует ли соответствующая запись о сдаче. Левое соединение помогает выразить такое отношение, но нужно дополнительно сверить охват заданий, поля сопоставления и последующие условия фильтрации. Замена одного слова соединения сама по себе не гарантирует правильного ответа. Официальное руководство PostgreSQL по соединениям
В Lab 7: рассуждения между отношениями на EvoClass учащиеся сверяют список зарегистрированных студентов со списком учебной платформы и наблюдают, как разные способы соединения сохраняют или исключают записи.
Полезное упражнение здесь — до написания запроса ясно сказать: кого представляет одна строка результата? Кто должен быть обязательно сохранён? Что означает ситуация, когда совпадающая запись не найдена?
С этими несколькими фразами у SQL появляется цель, с которой можно сверяться.
Перед запросом решите, как записывать мир
Продолжим смотреть на этот список. Студент может быть записан на несколько курсов, у одного курса может быть несколько заданий, а по каждому заданию может допускаться несколько попыток сдачи.
Если сложить всё это в одну большую таблицу, имя, название курса и сведения о преподавателе могут повторяться. Измените одно место — в других останутся старые значения; при подсчёте числа студентов один и тот же человек может быть посчитан несколько раз.
В этот момент проблема возникает ещё до запроса: что именно фиксирует каждая строка таблицы?
Lab 2: от реального мира к таблицам PostgreSQL начинает с избыточности и проблем обновления плоских таблиц и переходит к проектированию реляционной базы данных, а Lab 9: нормализация формы записи углубляется в нормализацию.
Можно начать с небольшого упражнения на бумаге: выпишите «студента», «курс» и «связь записи на курс» на трёх листах бумаги, а затем объясните, как они соединяются. Студент перевёлся на другую специальность — что нужно изменить? Новый курс ещё никто не выбрал — можно ли записать его заранее?
Такие вопросы заставляют структуру данных выдерживать проверку повседневными изменениями. Правильно ли разбиты таблицы, видно по тому, способны ли они ясно выражать отношения и оставаться согласованными при изменениях.
Возвращаясь к запросу из начала статьи, вам будет проще определить: несколько лишних строк перед вами — это несколько разных студентов или несколько сдач одного и того же студента?
Одна инструкция верна, а вся операция всё ещё может выполниться наполовину
После получения результата системе часто нужно ещё и изменить данные.
Например, студент просит перевестись в другую группу: его нужно убрать из старой группы и добавить в новую. Если первый шаг уже сохранён, а второй по какой-то причине не удался, студент может на время оказаться не в одной из групп. По отдельности обе инструкции могут быть написаны правильно; вместе они оставляют систему в незавершённом состоянии.
Транзакции дают базовый инструмент для такой проблемы: шаги, которые должны выполняться совместно, организуются так, чтобы фиксироваться как единое целое или отменяться при сбое. То, как очертить это «целое», по-прежнему требует понимания конкретной задачи. Официальное руководство PostgreSQL по транзакциям
Lab 10: эксперимент с транзакциями и параллелизмом переводит тему к границам транзакций и управлению параллелизмом: на фоне обработки мест у стойки записи на курсы учащиеся наблюдают, что происходит, когда два сеанса работают одновременно.
На практике можно намеренно вызвать сбой между двумя шагами операции, а затем посмотреть, что именно осталось в базе данных. Затем дайте двум сеансам одновременно работать с одними и теми же данными и проверьте, по-прежнему ли гладко выполняются шаги.
Так эксперимент обретает дополнительный смысл: важно не только увидеть, как всё получается, но и узнать, как оно может сломаться.
После того как AI написал SQL, что проверять самому?
С опытом предыдущих разделов взгляд на запрос, предложенный AI, меняется.
Список из начала статьи, в котором кто-то потерялся, можно проверить на трёх вымышленных записях студентов; проблему повторного подсчёта — добавив студента с двумя сдачами; операцию перевода в другую группу — проверив состояние данных при сбое посередине.
Такие небольшие примеры дают основание для суждения. Гладкое объяснение не заменяет проверку результата.
Lab 12: проверка SQL, сгенерированного AI включает рецензирование в упражнение: выполняется ли? Отвечает ли на вопрос? Что может нарушить? Кто имеет право это запускать?
Учащиеся могут шаг за шагом задавать вопросы по конкретной задаче: какие записи сохранит этот запрос? Сколько строк затронет изменение? Если предполагается изменить только одного человека, как до выполнения обнаружить неверно заданный охват? И означает ли наличие у инструмента прав на изменение, что текущая задача разрешает ему так поступать?
Тем, кто только знакомится с реляционными базами данных или уже начал писать запросы с помощью AI, страница курса DSAI2202 на EvoClass предлагает путь от базовых операций к более глубокому изучению. Можно заранее подготовить небольшой набор данных, который вы способны проверить вручную, и прийти на занятие с ожидаемым результатом.
В следующий раз, когда на экране появится аккуратный список, сначала поищите того, кого легче всего упустить.
Когда вы сможете объяснить, почему он присутствует и почему отсутствует, только тогда вы начнёте понимать, заслуживает ли этот ответ доверия.
Основание курса — официальное описание PolyU; описание лабораторных работ — по текущим материалам EvoClass. Ссылки на занятия ведут на учебные материалы на упрощённом китайском языке. Списки, сдачи работ и ситуация с переводом в другую группу — учебные примеры, построенные для понимания понятий; это не случаи студентов и не записи о результатах применения.