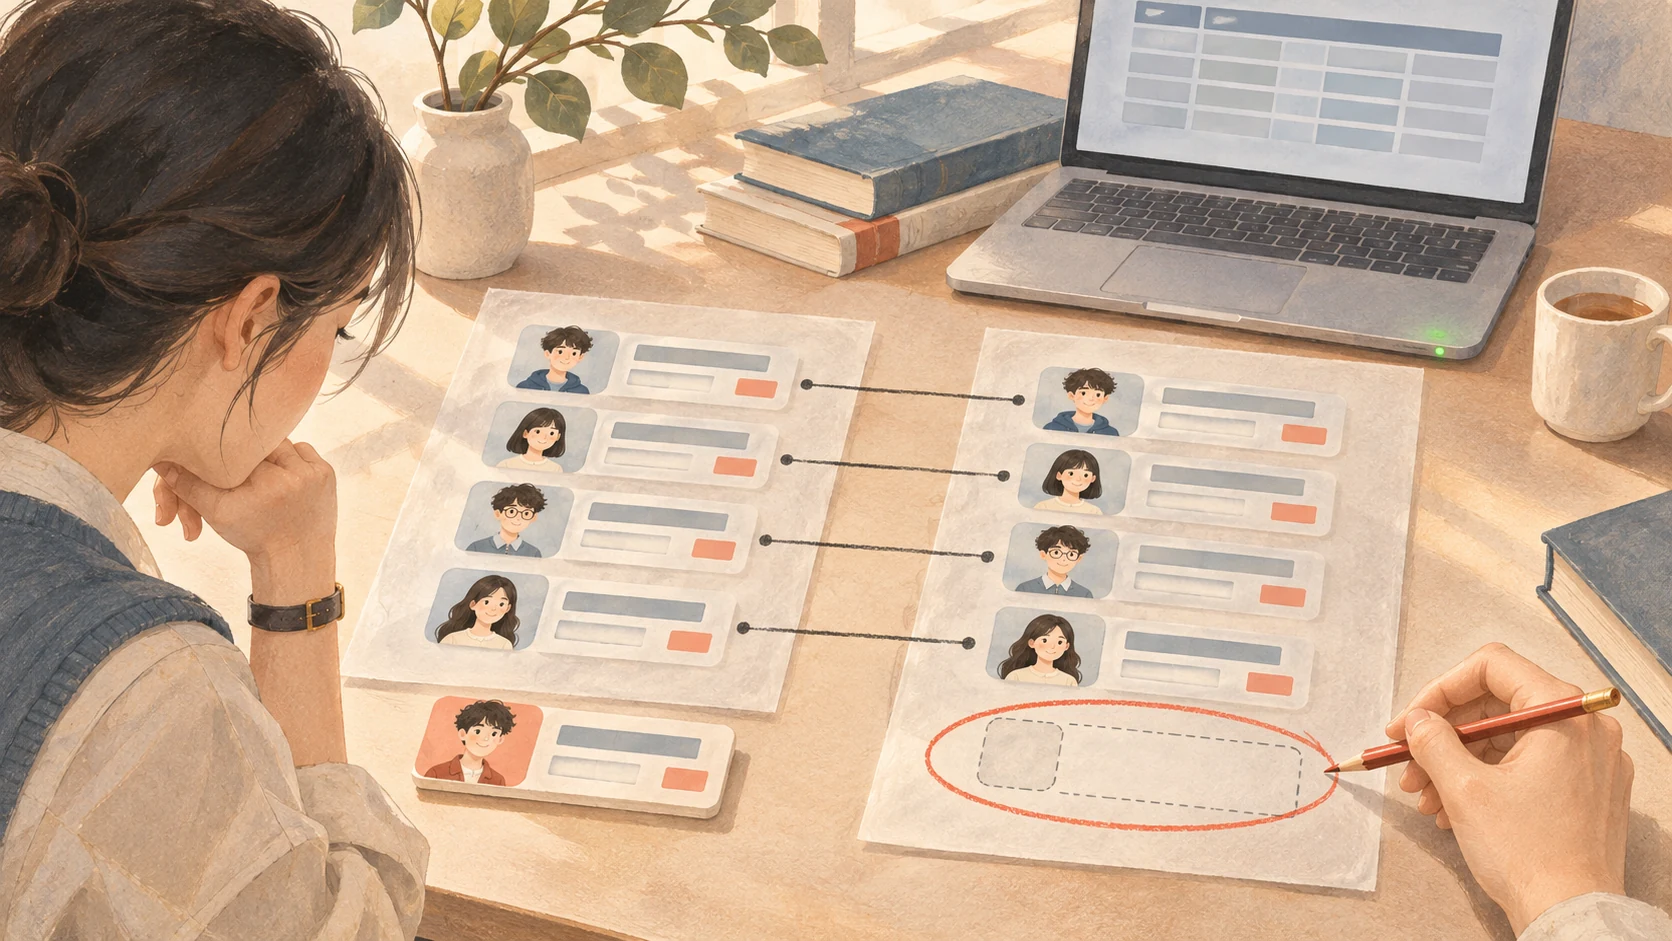
ある授業の場面を想像してみましょう。まだ課題を提出していない学生を特定したいと思い、AIに頼んでSQLを書いてもらいました。プログラムは問題なく動き、画面に整った名簿が表示されます。
エラーはなく、列名も合っています。さあリマインドを送ろうとしたそのとき、提出記録がまったくないある学生が、結果に含まれていないことに気づきます。
問題は結合の方法に潜んでいるかもしれません。そのクエリは2つのテーブルのうち一致するレコードだけを残しており、「まだ記録のない人」は最初から除外されていたのです。
こうした誤りは静かです。データベースは、あなたが書いた通りの操作をやり遂げました。本当に確認すべきなのは、その操作があなたの本来の意図を表しているかどうかです。
香港理工大学(PolyU)のDSAI2202「Database Principles」(データベース原理)では、データモデリング、SQL、トランザクション管理、データベースセキュリティなどを扱います。「なぜ結果から一人消えたのか」という問いを携えて授業に入れば、抽象的な概念にも追跡できる手がかりが生まれます。PolyU公式コース説明
名簿にいないのは、記録がないからか、そもそもその人がいないからか
まずは冒頭の例を小さくしてみましょう。
学生テーブルには3人がいます。アキラ、コハル、カイト。提出テーブルにはアキラとコハルの記録だけがあり、カイトはまだ提出していません。
もし内部結合で2つのテーブルを先につないでから「提出していない」学生を探すと、カイトはすでに中間結果の中にいません。その後の絞り込みをどれだけ丁寧にしても、早い段階で除外された人を取り戻すことはできません。
ひとつの考え方は、完全な学生名簿から出発し、すべての学生を保持したうえで、対応する提出記録があるかどうかを確認するというものです。左結合はこの関係を表現する助けになりますが、課題の範囲、照合する項目、その後の絞り込み条件についても引き続き確認する必要があります。結合の言葉をひとつ変えたからといって、答えが自動的に正しくなるわけではありません。PostgreSQL公式の結合チュートリアル
EvoClassのLab 7:関係をまたぐ推論では、学習者が学生の履修登録名簿と学習プラットフォームの名簿を照合し、結合の方法の違いによってレコードがどう保持され、あるいは除外されるかを観察します。
ここで練習する価値があるのは、クエリを書く前に、はっきり言葉にしておくことです。結果の1行は誰を表しているのか。どの人たちは必ず残さなければならないのか。一致する記録が見つからないとき、それは何を意味するのか。
これらの言葉があって初めて、SQLには照らし合わせるべき目標ができます。
クエリの前に、世界をどう記録するかを決める
この名簿をもう少し見ていきましょう。一人の学生は複数の科目を履修でき、ひとつの科目には複数の課題があり、それぞれの課題には複数回の提出が認められる場合もあります。
もしこれらをすべて一枚の大きな表に詰め込むと、氏名、科目名、教員情報が繰り返し現れるかもしれません。どこか一箇所を直しても、他の場所には古い値が残ってしまいます。学生数を数えるときには、同じ人を重複して数えてしまうかもしれません。
このとき問題は、すでにクエリの前に起きています。表の各行は、いったい何を記録しているのでしょうか。
Lab 2:現実世界からPostgreSQLのデータ表へでは、フラットな表の冗長性と更新の問題からリレーショナルデータベース設計へと入り、Lab 9:申込書の正規化ではさらに正規化を扱います。
紙とペンで小さな練習をしてみましょう。「学生」「科目」「履修関係」をそれぞれ3枚の紙に書き、それらがどうつながるのかを説明します。ある学生が専攻を変えたとき、どこを直す必要があるでしょうか。新しい科目にまだ誰も選んでいない場合、それを先に記録できるでしょうか。
こうした問いかけが、データ構造を日常的な変化の検証にさらします。表の分割が適切かどうかは、関係を明確に表現でき、かつ変更の際に一貫性を保てるかどうかで判断されます。
冒頭のクエリに戻れば、こうした判断もより容易になります。目の前に余分に現れている数行は、何人かの異なる学生なのか、それとも同じ学生の数回の提出なのか、と。
一つの文が正しくても、操作全体は半分しか終わっていないかもしれない
結果を調べた後、システムはしばしばデータも変更します。
たとえば、ある学生がクラス変更を申請し、元のクラスから外れて新しいクラスに加わる必要があるとします。もし最初のステップがすでに保存され、二番目のステップが何らかの理由で失敗したら、その学生は一時的にどのクラスにも属さない状態になるかもしれません。二つの文を別々に見れば、どちらも正しく書かれているでしょう。しかし合わせて見ると、システムには不完全な状態が残ってしまいます。
トランザクションはこのような問題に基本的な道具を提供します。共に完了すべきステップをまとめ、ひとつのまとまりとしてコミットするか、失敗したときに取り消すようにするのです。この「まとまり」をどう区切るかは、具体的なタスクを理解する必要があります。PostgreSQL公式のトランザクションチュートリアル
Lab 10のトランザクションと並行性の実験では、テーマをトランザクションの境界と並行性制御へと進め、履修登録窓口の定員処理を背景に、二つのセッションが同時に操作したときに何が起きるかを観察します。
練習では、二つのステップの間にあえて一度失敗を起こし、データベースにいったい何が残ったのかを確認してみましょう。続いて二つのセッションに同じデータを同時に操作させ、もともと順調だった手順がなお成立するかを見ます。
ひとつの実験が、それによってもう一段の意味を持ちます。物事がどう成功するかを見るだけでなく、それがどう失敗するかを知ることも必要なのです。
AIにSQLを書いてもらった後、自分は何を検証する責任を負うのか
ここまでの経験を経てからAIが出したクエリを見直すと、注目する点が変わってきます。
冒頭の人を抜け落とす名簿は、3件の架空の学生レコードで確認できます。重複カウントの問題は、2回提出した学生を加えてから確認できます。クラス変更の操作は、途中で失敗させたときにデータの状態を確認できます。
こうした小さな例が、判断の根拠を与えてくれます。流暢に書かれた説明は、結果の確認の代わりにはなりません。
Lab 12:AIが生成したSQLの検証では、レビューを練習に組み込みます。動くか。問題に答えているか。何を壊す可能性があるか。誰がそれを実行する権限を持つのか。
学習者は、ある具体的なタスクに沿って段階的に問いを重ねられます。このクエリはどのレコードを保持するのか。変更は何行に影響するのか。もし一人だけを変更するつもりなら、実行前に範囲の誤りをどう見つけるのか。ツールが変更権限を持っていることは、現在のタスクがそれを許していることを意味するのでしょうか。
リレーショナルデータベースに触れ始めたばかりの人、あるいはすでにAIの助けを借りてクエリを書き始めた人にとって、EvoClassのDSAI2202コース入口は、基礎的な操作からさらに深く進む道筋を提供します。まずは自分で手作業で確認できる小さなデータを用意し、期待する結果を持って練習に入るとよいでしょう。
次に画面に整った名簿が現れたときは、まず最も見落とされやすい人を探してみてください。
その人がなぜ現れ、なぜ欠けているのかを説明できて初めて、この答えが信頼に値するかどうかがわかり始めます。
コースの位置づけはPolyU公式のコース説明に基づき、実験の紹介はEvoClassの現行教材に基づいています。本文中の授業リンクは簡体字中国語の学習資料を指しています。名簿、課題提出、クラス変更の状況は、概念理解を助けるために構成された教育用の例であり、学生の事例や利用効果の記録ではありません。