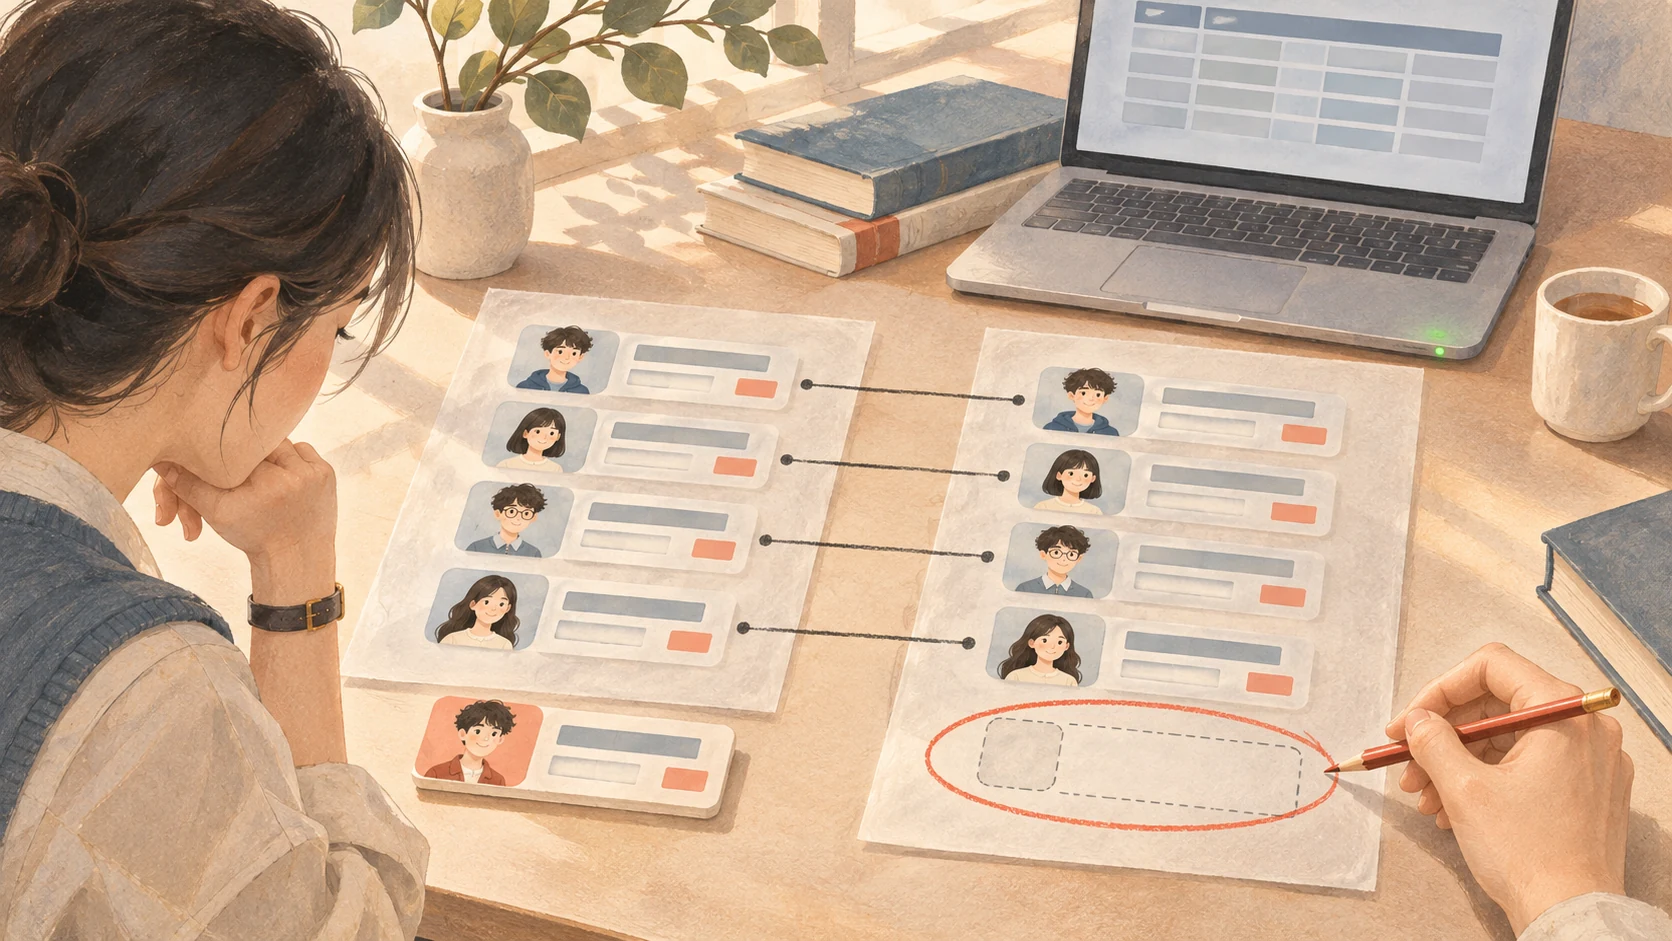
Imagina una situación docente: quieres encontrar a los estudiantes que aún no han entregado una tarea y le pides a una IA que escriba una consulta SQL. El programa se ejecuta sin inconvenientes y en la pantalla aparece una lista ordenada.
No hay errores y los nombres de las columnas coinciden. Estás a punto de enviar el recordatorio cuando notas que un estudiante que no tiene ningún registro de entrega no aparece en el resultado.
El problema puede estar escondido en el tipo de unión. La consulta solo conserva los registros que coinciden en las dos tablas, y "la persona que todavía no tiene registro" queda excluida desde el principio.
Este tipo de error es silencioso. La base de datos hizo exactamente lo que escribiste; lo que hace falta comprobar es si esas operaciones expresan lo que realmente querías decir.
El curso DSAI2202 «Database Principles» (Principios de bases de datos) de la Hong Kong Polytechnic University abarca modelado de datos, SQL, gestión de transacciones y seguridad de bases de datos, entre otros contenidos. Entrar al curso con preguntas como "¿por qué falta una persona en el resultado?" da a los conceptos abstractos una pista concreta que se puede seguir. Descripción oficial del curso en PolyU
¿No está en la lista porque no hay registro, o porque no existe esa persona?
Primero reduzcamos el ejemplo del inicio.
En la tabla de estudiantes hay tres personas: Ming, Xin y Jie. En la tabla de entregas solo hay registros de Ming y Xin; Jie aún no ha entregado.
Si primero unimos las dos tablas con una unión interna y luego buscamos a los estudiantes "que no han entregado", Jie ya no está en el resultado intermedio. Por más cuidadoso que sea el filtrado posterior, no podrá recuperar a alguien que fue excluido antes.
Una forma de abordarlo es partir de la lista completa de estudiantes, conservar a cada uno y luego comprobar si existe un registro de entrega correspondiente. La unión externa izquierda ayuda a expresar esta relación, pero todavía hay que revisar el alcance de la tarea, los campos de coincidencia y las condiciones de filtrado posteriores. Cambiar una palabra de unión no garantiza automáticamente que la respuesta sea correcta. Tutorial oficial de uniones de PostgreSQL
En el Lab 7: razonamiento entre relaciones de EvoClass, los estudiantes comparan la lista de matrícula con la lista de la plataforma de aprendizaje y observan cómo los distintos tipos de unión conservan o excluyen registros.
Lo que vale la pena practicar aquí es aclarar, antes de escribir la consulta: ¿a quién representa cada fila del resultado? ¿Qué personas deben conservarse obligatoriamente? ¿Qué significa no encontrar un registro coincidente?
Con estas pocas frases, SQL tiene un objetivo con el cual contrastarse.
Antes de consultar, decidir cómo registrar el mundo
Sigamos con esta lista. Un estudiante puede inscribirse en varios cursos, un curso puede tener varias tareas y cada tarea puede permitir varias entregas.
Si todo esto se mete en una sola tabla grande, el nombre, el nombre del curso y los datos del profesor podrían repetirse una y otra vez. Al cambiar uno de esos valores, otros lugares conservarían el valor antiguo; y al contar estudiantes, la misma persona podría contarse varias veces.
En ese momento, el problema ya ocurrió antes de la consulta: ¿qué registra exactamente cada fila de la tabla?
El Lab 2: del mundo real a las tablas de PostgreSQL parte de la redundancia y los problemas de actualización de las tablas planas para entrar en el diseño de bases de datos relacionales, y el Lab 9: normalización de una planilla de inscripción profundiza en la normalización.
Se puede empezar con un pequeño ejercicio en papel: escribir "estudiante", "curso" y "relación de inscripción" en tres hojas distintas y luego explicar cómo se conectan. Si un estudiante cambia de especialidad, ¿dónde hay que modificar? Si un curso nuevo todavía no tiene inscritos, ¿se puede registrar de todos modos?
Estas preguntas someten la estructura de datos a la prueba de los cambios cotidianos. Si las tablas están bien divididas se ve en si expresan con claridad las relaciones y mantienen la coherencia cuando algo se modifica.
Volviendo a la consulta del inicio, también será más fácil juzgar: las filas adicionales que tienes delante, ¿son varios estudiantes distintos o varias entregas del mismo estudiante?
Una sentencia correcta no garantiza que toda la operación se complete
Después de obtener un resultado, el sistema a menudo también debe modificar datos.
Por ejemplo, un estudiante solicita cambiar de grupo: hay que sacarlo del grupo original y agregarlo al nuevo. Si el primer paso ya se guardó y el segundo falla por algún motivo, el estudiante podría quedar temporalmente sin pertenecer a ningún grupo. Vistas por separado, ambas sentencias pueden estar bien escritas; consideradas en conjunto, el sistema queda en un estado incompleto.
Las transacciones ofrecen una herramienta básica para este tipo de problemas: agrupar los pasos que deben completarse juntos para que se confirmen como un todo o se deshagan si algo falla. Cómo delimitar ese "todo" sigue exigiendo comprender la tarea concreta. Tutorial oficial de transacciones de PostgreSQL
El laboratorio de transacciones y concurrencia del Lab 10 lleva el tema a los límites de las transacciones y al control de concurrencia, con el manejo de cupos en una mesa de inscripción como contexto, y observa qué ocurre cuando dos sesiones operan al mismo tiempo.
Al practicar, se puede provocar deliberadamente un fallo entre los dos pasos de una operación y luego revisar qué quedó realmente en la base de datos. Después, hacer que dos sesiones operen simultáneamente sobre los mismos datos y observar si los pasos que antes funcionaban sin problemas siguen siendo válidos.
Así, un experimento adquiere una capa adicional de significado: además de ver cómo las cosas salen bien, también hay que saber cómo fallan.
Después de pedirle SQL a una IA, ¿qué debo verificar yo mismo?
Con las experiencias anteriores, al mirar la consulta que propone una IA el foco cambia.
La lista incompleta del inicio puede comprobarse con tres registros ficticios de estudiantes; el problema del conteo duplicado puede verificarse agregando un estudiante con dos entregas; y la operación de cambio de grupo puede revisarse observando el estado de los datos cuando falla a mitad de camino.
Estos pequeños ejemplos dan una base para juzgar. Una explicación fluida no sustituye la verificación de los resultados.
El Lab 12: verificar el SQL generado por IA incorpora la revisión a la práctica: ¿se puede ejecutar? ¿Responde la pregunta? ¿Qué podría romper? ¿Quién tiene permiso para ejecutarlo?
Los estudiantes pueden ir preguntando paso a paso a partir de una tarea concreta: ¿qué registros conserva esta consulta? ¿Cuántas filas afectará la modificación? Si se espera modificar solo a una persona, ¿cómo detectar antes de ejecutar que el alcance está mal escrito? Y si la herramienta tiene permisos de modificación, ¿significa eso que la tarea actual permite usarlos de ese modo?
Para quienes se están iniciando en las bases de datos relacionales o ya han empezado a apoyarse en la IA para escribir consultas, el acceso al curso DSAI2202 en EvoClass ofrece una ruta para profundizar a partir de las operaciones básicas. Conviene preparar primero un conjunto pequeño de datos que uno mismo pueda verificar a mano y entrar a la práctica con resultados esperados.
La próxima vez que en la pantalla aparezca una lista ordenada, busca primero a la persona más fácil de pasar por alto.
Cuando puedas explicar por qué aparece y por qué falta, empezarás a saber si esa respuesta merece confianza.
El enfoque del curso se basa en la descripción oficial de PolyU, y la presentación de los laboratorios se basa en los materiales actuales de EvoClass. Los enlaces a las lecciones del texto apuntan a materiales de aprendizaje en chino simplificado. Las situaciones de listas, entregas de tareas y cambios de grupo son ejemplos didácticos construidos para facilitar la comprensión de los conceptos, no casos de estudiantes ni registros de resultados de uso.