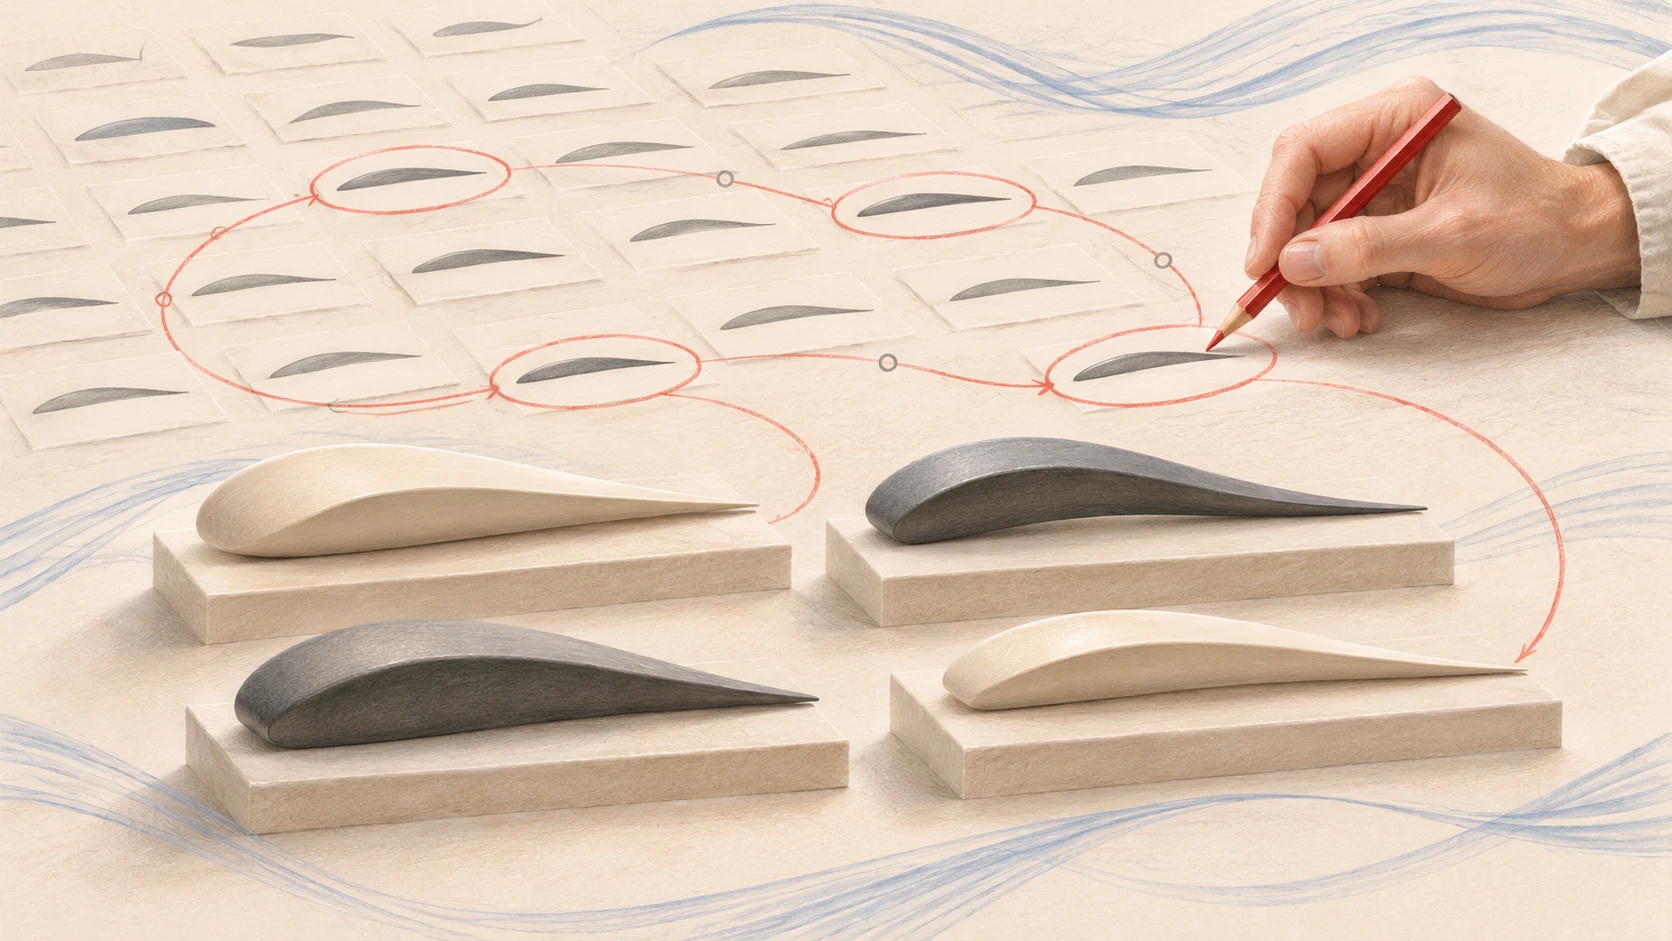
Что именно означает «лучше», когда речь идёт об улучшении аэродинамического профиля?
Эффективность крейсерского режима хотелось бы повысить, а проектные ограничения необходимо соблюсти, при этом каждая высокоточная оценка расходует вычислительный бюджет. Один вариант оказывается сильнее по одному показателю, другой сохраняет больший запас по другому. Выстроить их в один ряд и выбрать первого — задача не такая простая, как кажется.
ИИ может участвовать в выдвижении новых вариантов и в написании кода экспериментов. После этого приходится решать, как оценивать, сравнивать и продолжать поиск.
Курс AI999 «Интеллектуальная эволюционная система EvoX и практика AI Native в научных исследованиях» от EvoClass развивает эту линию: от эволюционных вычислений к многокритериальным задачам, далее к современной вычислительной основе, эволюции методов и научной практике в среде AI Native. Его интересует, как очередное предложение попадает в эксперимент и как обратная связь меняет следующее предложение.
Сначала уточним, какие улучшения стоит сохранять
Урок 3 «Сложность реального мира и многокритериальные компромиссы» на примере проектирования аэродинамического профиля и других ситуаций обсуждает соотношение между целями, ограничениями и стоимостью оценки.
Одни показатели хочется по возможности повысить, другие условия необходимо выполнить. Только разграничив эти два типа требований, можно получить основу для сравнения.
Если из набора кандидатов какой-то вариант уступает по всем интересующим показателям, есть основания его исключить; если же несколько вариантов имеют каждый свои выгоды и издержки, сохранение этих различий, напротив, делает последующий выбор более ясным. Эксперты в предметной области, опираясь на конкретные условия работы и предпочтения, могут решить, какие направления стоит продолжать.
Это же побуждает исследователя проверить собственную схему оценки. Как вычисляется итоговая оценка? Почему веса заданы именно так? Не лишат ли ограничения, изначально не включённые в расчёт, высокобалльный вариант практической ценности?
Ответы на эти вопросы нужно дать в дизайне эксперимента. Иначе поиск сможет продвигаться по баллам, постепенно отклоняясь от действительно важной задачи.
Кандидатов всё больше — куда направить бюджет оценки?
Сохранение множества возможностей порождает новые издержки.
В уроке 3 также рассматриваются суррогатные модели: по имеющимся образцам они учатся связи между параметрами кандидатов и их характеристиками, помогают отбирать варианты с помощью более дешёвых предсказаний, затем отправляют заслуживающие глубокой проверки кандидаты на более точную оценку, а результаты используют для последующего обновления.
Здесь важно различать вес разных свидетельств. У суррогатного предсказания есть погрешность, и проверка особенно нужна, когда поиск выходит в незнакомую область. Высокий прогнозный балл всё равно требует дальнейшей проверки.
Другая часть издержек связана со способом организации вычислений. Урок 4 «Современная вычислительная основа и тензоризованная параллельная эволюция» обсуждает, как организовать популяцию, результаты оценки и состояние в виде тензоров и продвигать вычисления пакетами.
Это можно понять так: параметры множества кандидатов выстраиваются в согласованную структуру, а операции, способные выполняться пакетно, обрабатывают их совместно. Документация EvoX по разработке собственных задач также описывает такой способ организации через интерфейс оценки, принимающий партию кандидатов и возвращающий соответствующие значения целевой функции.
Фактическую выгоду всё равно нужно измерять: на что уходит время — на генерацию кандидатов, целевую функцию или на перемещение данных? Не занимает ли увеличенный пакет слишком много видеопамяти? Только раздельно фиксируя эти издержки, можно понять, что менять дальше.
Суррогатная оценка и пакетный параллелизм решают соответственно проблемы стоимости оценки и организации вычислений. Понимание их разделения ролей полезнее, чем общее ожидание, что «если запустить побольше, станет лучше».
Когда поиск застопорился, стоит проверить и метод порождения кандидатов
Если после множества дополнительных раундов результат заметно не улучшился, проверять стоит не только сами кандидаты.
Как происходит мутация? Как заданы параметры? Подходит ли текущий способ поиска этой задаче?
Урок 5 «Эволюция методов: от оптимизации решения к оптимизации самого алгоритма» на материалах MetaDE, AutoPSO и других включает в обсуждение и сам метод порождения кандидатов.
На примере MetaDE: внутренний уровень — дифференциальная эволюция — решает целевую задачу, а внешний ищет стратегии и конфигурации параметров по результатам решения. Так, помимо сравнения «какое решение получено», можно сравнивать и «каким способом ищется решение».
Этот уровень изменений тоже требует затрат. При сравнении методов в бюджет следует включать, сколько оценок использовали внутренний и внешний уровни и сколько времени они заняли; выводы также нужно понимать в контексте протестированных задач и условий.
Для учащегося одно из возможных упражнений — сначала построить чёткую базовую линию, затем изменить одну стратегию, сохранить конфигурацию и полные результаты и выполнить повторные запуски. Так появляется шанс объяснить изменение результатов и легче заметить, какие изменения выглядели удачно лишь в одном запуске.
После того как код написан, что должно остаться от исследования?
Когда ИИ способен участвовать в реализации всё большего числа экспериментов, число решений, которые нужно принять исследователю, не уменьшается.
Обсуждение Genesis и непрерывной эволюции программного обеспечения в уроке 6 переводит внимание на проект: как декомпозировать задачи, как проверять изменения кода, как результативные результаты становятся основой дальнейшей работы. Официальное описание проекта Genesis также организует сборку, проверку и дальнейшую разработку в едином рабочем пути.
Однако выводы, которые подтверждаются успешной компиляцией и прохождением тестов, нужно отличать от научных выводов. Они могут показать, что программа удовлетворяет уже проверенным требованиям; эффективнее ли метод, зависит ещё от постановки задачи, контрольных экспериментов, метрик оценки и анализа результатов.
Урок 7 «Парадигма AI Native в научных исследованиях и практический вход в EvoX» возвращает эту ответственность исследователю: ставить вопрос, определять оценку, выбирать направление и критически оценивать уже полученные результаты.
«Научный вкус» тоже становится от этого конкретнее. Выбирается ли задача потому, что она важна, или потому, что легко получить красивые результаты? Способна ли оценка проверить собственное утверждение? Сможет ли следующий исследователь, получив код, описание окружения, параметры и журналы запусков, перепроверить этот эксперимент?
Если вы уже начали писать код экспериментов с помощью ИИ, можно начать с небольшой задачи, которую вы способны проверить сами: сначала записать цели и ограничения, определить бюджет и базовую линию, затем запускать, сравнивать, фиксировать и решать, что сохранить в следующем раунде. Обзор курса AI999 от EvoClass даёт точку входа для продолжения обучения по этому пути.
Возвращаясь к первоначальному набору кандидатов аэродинамического профиля, результатом исследования, возможно, на время станет обоснованный набор компромиссов: какие варианты стоит сохранить, какие требуют дополнительной оценки, какие направления уже не заслуживают продолжения.
Когда эти суждения и свидетельства могут быть унаследованы следующим экспериментом, у пока ещё не лучшего решения появляется отправная точка для дальнейшего улучшения.
Описание курса основано на текущих материалах EvoClass AI999; технический контекст дополнительно опирается на официальные материалы проектов, ссылки на которые приведены в тексте. Обсуждение аэродинамического профиля служит иллюстрацией связи между целями и ограничениями; изложенные в тексте планы экспериментов являются учебными рекомендациями, а не проведённой в данной статье оценкой производительности. Ссылки на уроки ведут на учебные материалы на упрощённом китайском языке.