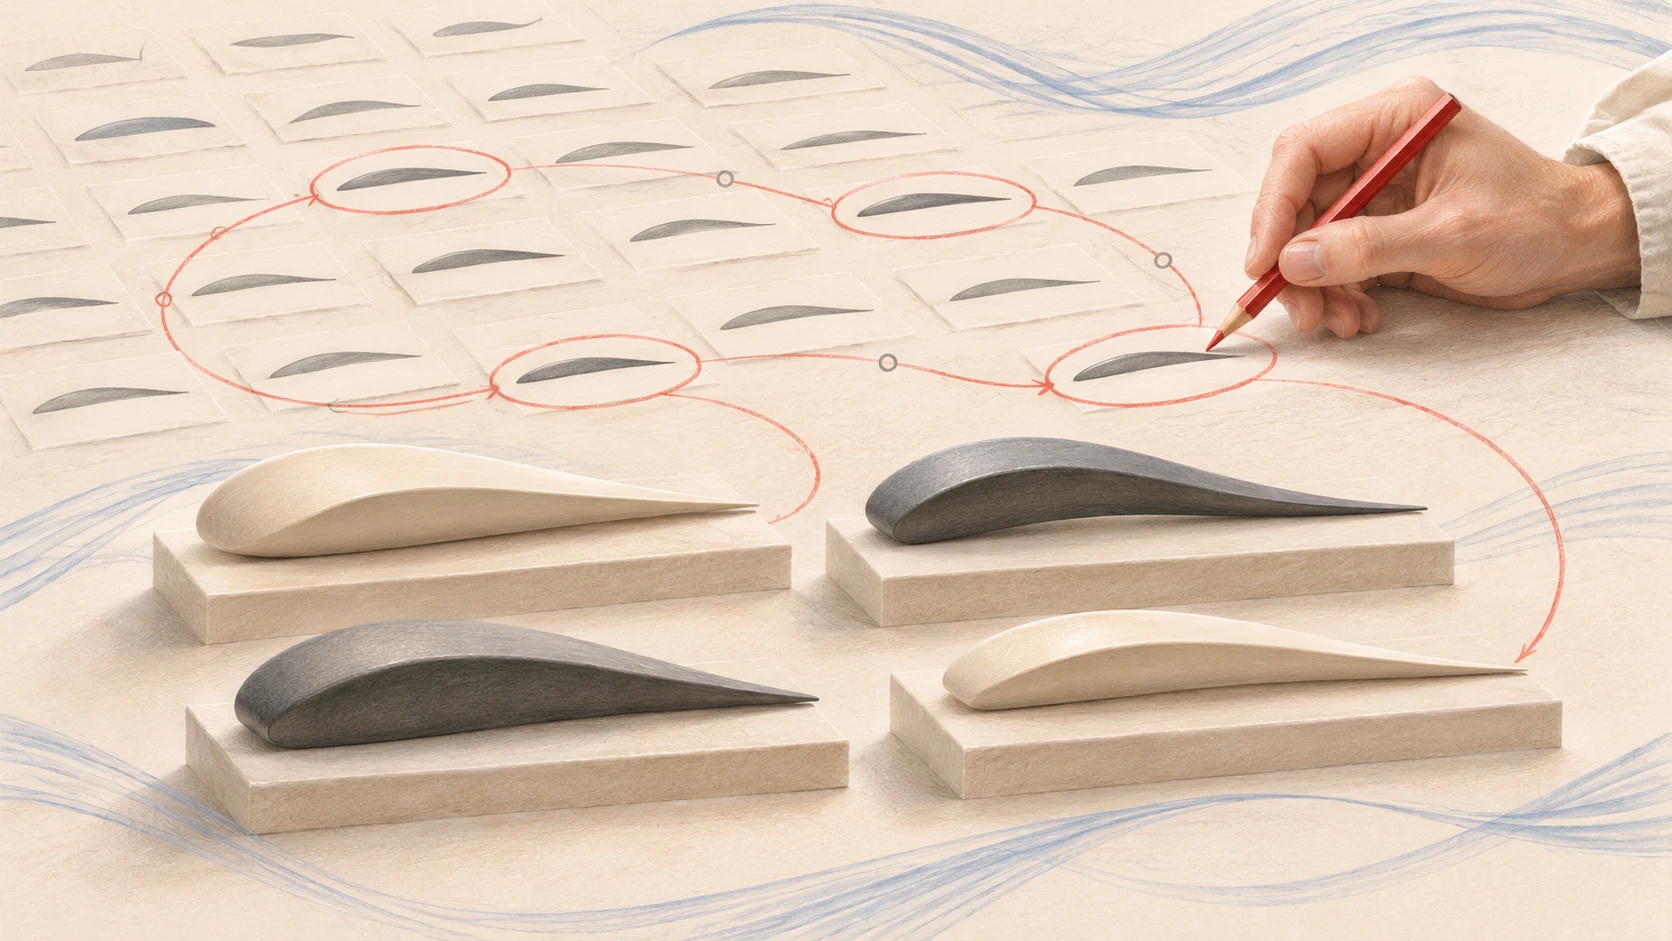
ถ้าจะปรับปรุงปีกอากาศสักหนึ่งแบบ คำว่า "ดีขึ้น" แท้จริงหมายถึงอะไร?
ประสิทธิภาพการล่องเรือควรสูงขึ้น ข้อจำกัดในการออกแบบก็ต้องเป็นไปตามที่กำหนด และการประเมินที่มีความแม่นยำสูงแต่ละครั้งก็กินงบประมาณการคำนวณ แบบที่เสนอแบบหนึ่งอาจโดดเด่นกว่าในตัวชี้วัดหนึ่ง อีกแบบกลับอาจเก็บพื้นที่เผื่อไว้ได้มากกว่า การจัดเรียงพวกมันเป็นแถวและเลือกตัวที่ดีที่สุดนั้น ไม่ได้ตรงไปตรงมาอย่างที่คิด
AI สามารถร่วมเสนอแนวทางใหม่และเขียนโค้ดทดลองได้ สิ่งที่ตามมาคือ จะประเมิน เปรียบเทียบ และสำรวจต่อไปอย่างไร
หลักสูตร AI999《ระบบวิวัฒนาการอัจฉริยะ EvoX และการปฏิบัติงานวิจัยแบบ AI Native》ของ EvoClass ดำเนินไปตามเส้นทางนี้: จากการคำนวณเชิงวิวัฒนาการเข้าสู่ปัญหาหลายเป้าหมาย จากนั้นจึงพูดถึงฐานการคำนวณสมัยใหม่ วิวัฒนาการของวิธีการ และการปฏิบัติงานวิจัยในสภาพแวดล้อมแบบ AI Native สิ่งที่หลักสูตรให้ความสนใจคือ ข้อเสนอหนึ่งเข้าสู่การทดลองได้อย่างไร และผลตอบกลับเปลี่ยนข้อเสนอครั้งถัดไปอย่างไร
ก่อนอื่นต้องชัดเจนว่า การปรับปรุงแบบใดควรค่าแก่การเก็บไว้
บทเรียนที่ 3《ความซับซ้อนของโลกจริงและการแลกเปลี่ยนหลายเป้าหมาย》 ใช้สถานการณ์อย่างการออกแบบปีกอากาศเพื่ออภิปรายความสัมพันธ์ระหว่างเป้าหมาย ข้อจำกัด และต้นทุนการประเมิน
ตัวชี้วัดบางตัว我们希望ให้สูงที่สุดเท่าที่จะเป็นไปได้ ส่วนเงื่อนไขบางอย่างต้องผ่านเกณฑ์ให้ได้ การแยกความต้องการสองประเภทนี้ออกจากกันก่อน จึงจะมีพื้นฐานสำหรับการเปรียบเทียบ
เมื่อเผชิญกับกลุ่มตัวเลือก หากแบบหนึ่งตามหลังอย่างรอบด้านในตัวชี้วัดที่สนใจ ก็มีเหตุผลที่จะตัดมันออก หากหลายแบบต่างมีทั้งผลได้และราคาที่ต้องจ่าย การเก็บความแตกต่างเหล่านี้ไว้กลับทำให้การเลือกในภายหลังชัดเจนขึ้น ผู้เชี่ยวชาญในสาขาสามารถพิจารณาสภาวะการทำงานและความชอบเฉพาะเพื่อตัดสินว่าทิศทางใดควรไปต่อ
สิ่งนี้ยังเตือนให้นักวิจัยตรวจสอบวิธีประเมินของตนเองด้วย คะแนนรวมคำนวณมาอย่างไร? ทำไมจึงตั้งน้ำหนักแบบนั้น? ข้อจำกัดที่ไม่ได้เขียนไว้แต่แรก จะทำให้แบบที่ได้คะแนนสูงสูญเสียคุณค่าในการใช้งานหรือไม่?
คำถามเหล่านี้ต้องได้รับคำตอบในการออกแบบการทดลอง มิฉะนั้นการค้นหาอาจก้าวหน้าไปตามคะแนนเรื่อย ๆ แต่ค่อย ๆ เบี่ยงเบนออกจากภารกิจที่เราใส่ใจจริง
เมื่อตัวเลือกมากขึ้นเรื่อย ๆ ควรใช้งบประมาณการประเมินตรงไหน?
การเก็บความเป็นไปได้ไว้หลายทางย่อมนำมาซึ่งต้นทุนใหม่
บทเรียนที่ 3 ยังอภิปรายถึงตัวแบบตัวแทน (surrogate model): การเรียนรู้ความสัมพันธ์ระหว่างพารามิเตอร์ของตัวเลือกกับสมรรถนะจากตัวอย่างที่มีอยู่ ใช้การพยากรณ์ที่มีต้นทุนต่ำช่วยคัดกรอง แล้วส่งตัวเลือกที่ควรตรวจสอบอย่างละเอียดไปประเมินด้วยความแม่นยำที่สูงขึ้น และนำผลลัพธ์ไปใช้ในการปรับปรุงครั้งถัดไป
ตรงนี้ต้องแยกแยะน้ำหนักของหลักฐานแต่ละประเภท การพยากรณ์จากตัวแบบตัวแทนมีความคลาดเคลื่อน โดยเฉพาะอย่างยิ่งเมื่อการค้นหาเข้าไปในพื้นที่ที่ไม่คุ้นเคย ยิ่งต้องตรวจทาน คะแนนพยากรณ์ที่ดูสูงมากยังต้องผ่านการตรวจสอบต่อไป
ต้นทุนอีกส่วนหนึ่งมาจากวิธีการจัดระเบียบการคำนวณ บทเรียนที่ 4《ฐานการคำนวณสมัยใหม่และวิวัฒนาการแบบขนานด้วยเทนเซอร์》 อภิปรายถึงการจัดระเบียบประชากร ผลการประเมิน และสถานะให้เป็นเทนเซอร์ เพื่อขับเคลื่อนการคำนวณเป็นชุด ๆ
อาจเข้าใจได้ว่า: จัดเรียงพารามิเตอร์ของตัวเลือกจำนวนมากตามโครงสร้างที่สอดคล้องกัน เพื่อให้การดำเนินการที่สามารถประมวลผลเป็นชุดจัดการ它們ร่วมกัน เอกสารการพัฒนาปัญหาแบบกำหนดเอง ของ EvoX ก็ใช้อินเทอร์เฟซการประเมินที่รับตัวเลือกเป็นชุดและคืนค่าตัวชี้วัดเป้าหมายที่สอดคล้องกัน来说明วิธีการจัดระเบียบนี้
ผลตอบแทนจริงยังต้องวัด: เวลาหมดไปกับการสร้างตัวเลือก ฟังก์ชันเป้าหมาย หรือการย้ายข้อมูล? ขนาดชุดที่ใหญ่ขึ้นกินหน่วยความจำกราฟิกมากเกินไปหรือไม่? การบันทึกค่าใช้จ่ายเหล่านี้แยกจากกันจึงจะรู้ว่าครั้งหน้าควรแก้อะไร
การประเมินที่ช่วยด้วยตัวแบบตัวแทนและการประมวลผลแบบขนานเป็นชุด ต่างจัดการปัญหาต้นทุนการประเมินและปัญหาการจัดระเบียบการคำนวณตามลำดับ การเข้าใจการแบ่งงานของทั้งสองอย่างมีประโยชน์กว่าการคาดหวังลอย ๆ ว่า "รันเพิ่มอีกหน่อยก็จะดีขึ้นเอง"
เมื่อการค้นหาหยุดชะงัก ก็ตรวจดูวิธีการที่สร้างตัวเลือกได้เช่นกัน
รันไปหลายรอบแล้ว แต่ผลลัพธ์กลับไม่ดีขึ้นอย่างชัดเจน คราวนี้สิ่งที่ควรตรวจสอบไม่ได้มีเพียงตัวเลือกเท่านั้น
การกลายพันธุ์เกิดขึ้นอย่างไร? พารามิเตอร์ตั้งไว้อย่างไร? วิธีการค้นหาปัจจุบันเหมาะสมกับปัญหานี้หรือไม่?
บทเรียนที่ 5《วิวัฒนาการของวิธีการ: จากผลเฉลยที่เหมาะสมที่สุด สู่อัลกอริทึมที่เหมาะสมที่สุดเอง》 ใช้เนื้อหาอย่าง MetaDE และ AutoPSO เพื่อนำวิธีการที่สร้างตัวเลือกเข้ามาอภิปรายด้วย
ยกตัวอย่าง MetaDE: ชั้นในเป็นวิวัฒนาการเชิงผลต่าง (differential evolution) ที่แก้ปัญหาตามเป้าหมาย ส่วนชั้นนอกค้นหากลยุทธ์และการตั้งค่าพารามิเตอร์โดยอิงจากสมรรถนะในการแก้ปัญหา ดังนั้นนอกจากเปรียบเทียบ "ได้ผลเฉลยอะไร" ยังสามารถเปรียบเทียบ "ค้นหาผลเฉลยด้วยวิธีใด" ได้อีกด้วย
การเปลี่ยนแปลงในระดับนี้ก็มีต้นทุนที่ต้องจ่ายเช่นกัน เมื่อเปรียบเทียบวิธีการ จำนวนครั้งการประเมินที่ชั้นในและชั้นนอกใช้ และเวลาการทำงานที่กินไป ควรถูกนับเข้างบประมาณด้วย และข้อสรุปก็ต้องนำกลับไปทำความเข้าใจในบริบทของปัญหาและเงื่อนไขที่ทดสอบ
สำหรับผู้เรียน แบบฝึกหัดหนึ่งที่ลองได้คือ สร้างเส้นฐาน (baseline) ที่ชัดเจนก่อน แล้วเปลี่ยนกลยุทธ์หนึ่งอย่าง เก็บการตั้งค่าและผลลัพธ์ทั้งหมดไว้ และรันซ้ำหลายครั้ง ด้วยวิธีนี้ การเปลี่ยนแปลงของสมรรถนะจึงมีโอกาสถูกอธิบายได้ และง่ายกว่าที่จะพบว่าการแก้ไขใดดูดีเพียงในการรันครั้งเดียว
เมื่อเขียนโค้ดเสร็จแล้ว งานวิจัยยังต้องเหลืออะไรไว้?
เมื่อ AI สามารถร่วมลงมือทำการทดลองได้มากขึ้น การตัดสินใจที่นักวิจัยต้องทำกลับไม่ได้ลดลงตามไปด้วย
การอภิปรายในบทเรียนที่ 6 เกี่ยวกับ Genesis และวิวัฒนาการซอฟต์แวร์อย่างต่อเนื่อง ผลักดันจุดสนใจไปสู่ระดับโครงการ: งานถูกแบ่งย่อยอย่างไร การแก้ไขโค้ดได้รับการตรวจสอบอย่างไร ผลลัพธ์ที่มีประสิทธิผลเข้าสู่พื้นฐานของงาน subsequent อย่างไร คำอธิบายโครงการอย่างเป็นทางการ ของ Genesis ก็จัดระเบียบการสร้าง การตรวจสอบ และการพัฒนาต่อไว้ในเส้นทางการทำงานเดียวกัน
อย่างไรก็ตาม ข้อสรุปที่การคอมไพล์และการทดสอบผ่านรองรับ จำเป็นต้องแยกแยะออกจากข้อสรุปทางวิทยาศาสตร์ สิ่งเหล่านี้สามารถระบุได้ว่าโปรแกรมเป็นไปตามข้อกำหนดที่ตรวจสอบแล้ว แต่การที่วิธีการหนึ่งจะมีประสิทธิผลมากกว่าหรือไม่ ยังต้องดูจากการตั้งปัญหาการทดลองเปรียบเทียบ ตัวชี้วัดการประเมิน และการวิเคราะห์ผลลัพธ์
บทเรียนที่ 7《กระบวนทัศน์การวิจัยแบบ AI Native และการเข้าสู่ภาคปฏิบัติด้วย EvoX》 นำความรับผิดชอบนี้กลับมาสู่นักวิจัย: การตั้งคำถาม การนิยามการประเมิน การตัดสินทิศทาง และการวิพากษ์ผลลัพธ์ที่มีอยู่
"รสนิยมทางการวิจัย" จึงสามารถเป็นสิ่งที่เป็นรูปธรรมได้จากจุดนี้ เราเลือกปัญหานี้เพราะมันสำคัญ หรือเพราะได้ผลลัพธ์ที่ดูดีได้ง่าย? การประเมินสามารถทดสอบข้ออ้างของเราได้หรือไม่? เมื่อนักวิจัยคนถัดไปได้รับโค้ด คำอธิบายสภาพแวดล้อม พารามิเตอร์ และบันทึกการรัน เขาจะตรวจสอบการทดลองครั้งนี้ซ้ำได้หรือไม่?
หากคุณเริ่มใช้ AI ช่วยเขียนโค้ดทดลองแล้ว สามารถเริ่มจากปัญหาขนาดเล็กที่ตนเองตรวจสอบได้: เขียนเป้าหมายและข้อจำกัดก่อน กำหนดงบประมาณและเส้นฐาน จากนั้นรัน เปรียบเทียบ บันทึก และตัดสินใจว่าจะเก็บอะไรไว้ในรอบถัดไป ภาพรวมหลักสูตร AI999 ของ EvoClass เป็นทางเข้าสำหรับเรียนรู้ต่อไปตามเส้นทางนี้
กลับไปยังกลุ่มตัวเลือกปีกอากาศตอนต้น ผลตอบแทนจากการวิจัยอาจยังเป็นเพียงชุดของการแลกเปลี่ยนที่มีเหตุผลรองรับในตอนนี้: แบบใดควรเก็บไว้ แบบใดต้องประเมินเพิ่มเติม และทิศทางใดไม่คุ้มที่จะไปต่อแล้ว
เมื่อการตัดสินใจและหลักฐานเหล่านี้สามารถถูกส่งต่อให้การทดลองครั้งถัดไปสืบทอดได้ แบบที่ยังดีไม่พอก็มีจุดเริ่มต้นสำหรับการปรับปรุงต่อไป
คำอธิบายหลักสูตรอ้างอิงจากเนื้อหาปัจจุบันของ EvoClass AI999 ส่วนภูมิหลังทางเทคนิคอ้างอิงเพิ่มเติมจากเอกสารโครงการอย่างเป็นทางการที่เชื่อมโยงในบทความ การอภิปรายเรื่องปีกอากาศใช้เพื่ออธิบายความสัมพันธ์ระหว่างเป้าหมายและข้อจำกัด การจัดเตรียมการทดลองในบทความเป็นข้อเสนอแนะเพื่อการเรียนรู้ ไม่ใช่การวัดสมรรถนะที่บทความนี้ดำเนินการ ลิงก์บทเรียนชี้ไปยังเนื้อหาการเรียนรู้ภาษาจีนตัวย่อ