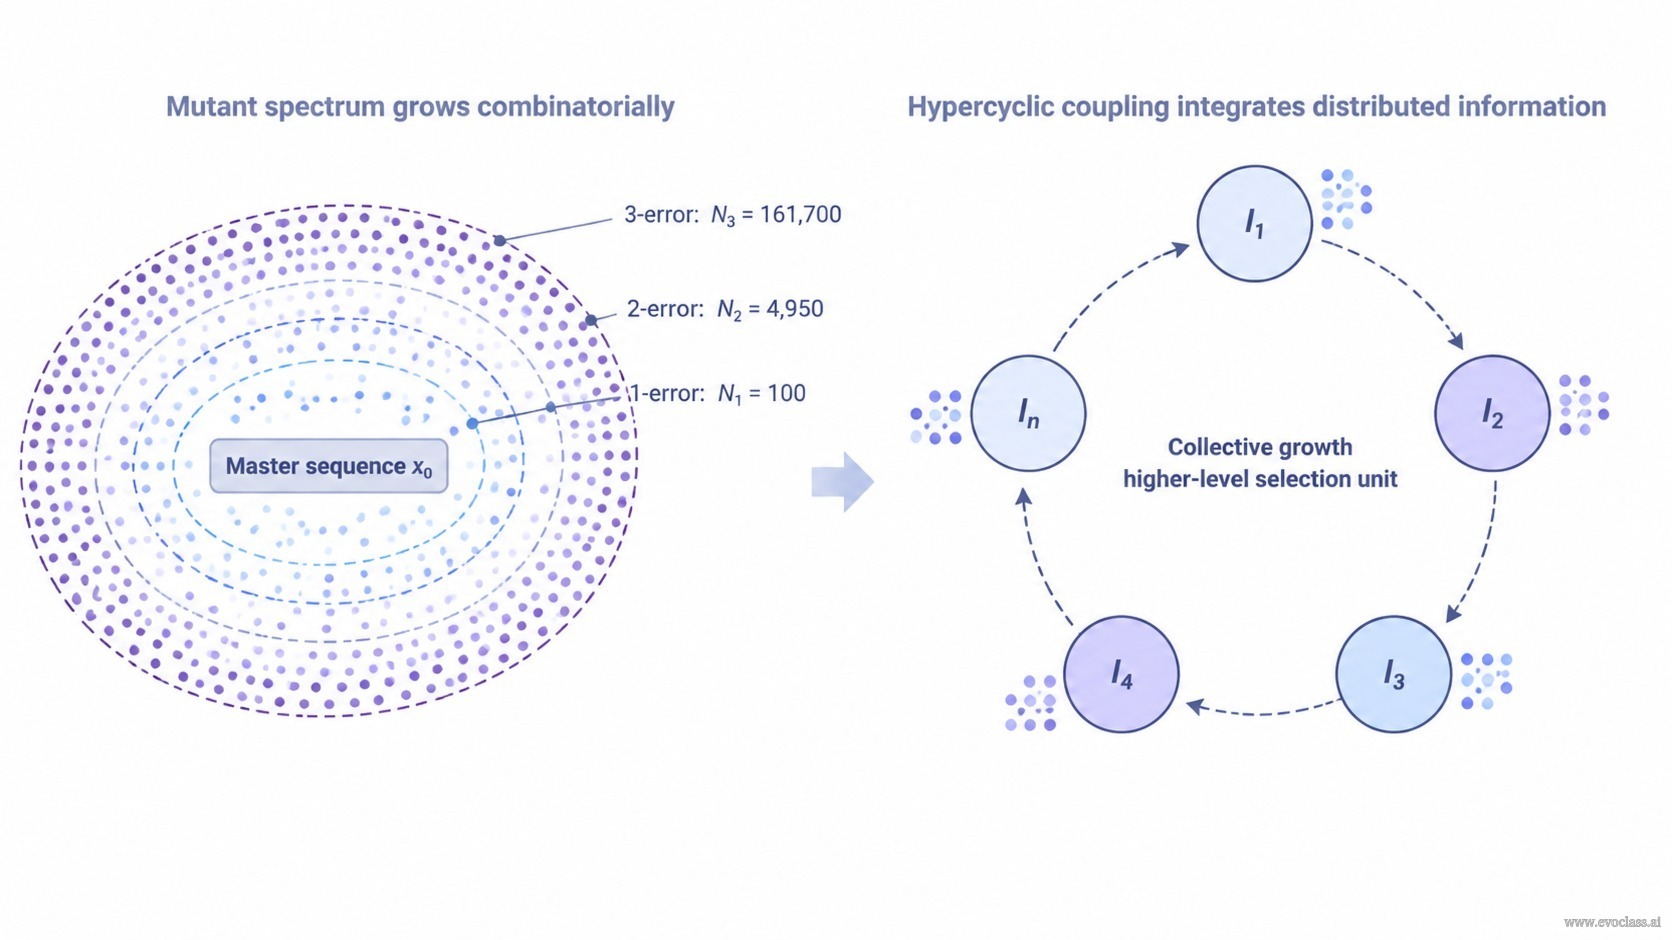
Ngưỡng sai số giới hạn lượng thông tin mà một bộ gen đơn lẻ phát triển ổn định có thể duy trì. Sao chép không bao giờ chính xác tuyệt đối, nên mỗi vòng tái bản bao quanh trình tự gốc bằng một phổ đột biến gồm các biến thể một, hai, ba lỗi và cao hơn. Dưới cân bằng đột biến–chọn lọc, phổ này không phải là phiền toái nhỏ: chọn lọc tác động lên toàn bộ phân bố có tổ chức — quần thể loài gần (quasi-species) — chứ không phải lên một phân tử đặc quyền duy nhất.
Điều đánh bại một bộ gen đơn lẻ là số học của phổ đó, vốn tăng theo tổ hợp khi độ dài bộ gen tăng. Với bộ gen 100 nucleotide:
Dạng tổng quát:
Ba hệ quả rút ra. Thứ nhất, đám mây đột biến rất lớn so với bản thân trình tự gốc: khi độ dài bộ gen hoặc tốc độ đột biến tăng, đám mây lấn át bản gốc, ngưỡng sai số bị vượt qua và thông tin được mã hóa bị suy giảm. Thứ hai, một bộ gen đơn lẻ phát triển ổn định không thể tích hợp sự đa dạng này — các thể tái bản của nó cạnh tranh, các biến thể nhanh hơn hoặc ngắn hơn lấn át bản gốc, và chọn lọc tác động lên từng phân tử riêng lẻ không có cơ chế giữ toàn bộ tập đột biến lại với nhau như một đơn vị ổn định.
Tổ chức siêu chu trình bổ sung điều gì
Tổ chức siêu chu trình giải quyết vấn đề bằng cách liên kết các gen khác nhau thông qua sự phụ thuộc xúc tác lẫn nhau. Sản phẩm của mỗi gen xúc tác sự tái bản của thành viên kế tiếp, khép kín chu trình I1 → I2 → … →
- Liên kết tuần hoàn: sự phụ thuộc xúc tác biến các đối thủ độc lập thành một mạng hợp tác, nên không một biến thể nhanh nào có thể đơn giản chiếm lấy quần thể.
- Chức năng phân tán: thông tin được trải rộng trên nhiều thành viên, nên một mức độ biến đổi đột biến có thể được hấp thụ mà không làm sụp đổ ngay thông tin tích hợp.
- Đơn vị chọn lọc cấp cao hơn: chu trình — chứ không phải thể tái bản riêng lẻ — trở thành đối tượng mà sự phát triển và sinh sản của nó quyết định sự sống còn.
Giới hạn của giải pháp
Sự tích hợp không phải là vô hạn. Bản thân các siêu chu trình cũng có ngưỡng sai số, và chúng dễ bị tổn thương bởi các thành viên ký sinh lợi dụng chu trình mà không đóng góp xúc tác. Do đó, tổ chức siêu chu trình di dời và phân chia vấn đề thông tin chứ không xóa bỏ nó.
Tại sao cần tổ chức siêu chu trình của các gen đột biến
Bên trái, một trình tự gốc 100 nucleotide được bao quanh bởi phổ đột biến của nó, với kích thước tăng theo tổ hợp: 100 đột biến một lỗi, 4.950 đột biến hai lỗi và 161.700 đột biến ba lỗi. Bên phải, chính sự đa dạng đó được phân chia thành các gen liên kết trong một chu trình xúc tác khép kín I 1 → I 2 → … → I n → I 1, nên mạng phát triển và được chọn lọc một cách tập thể như một đơn vị cấp cao hơn. Điểm mấu chốt là liên kết siêu chu trình tích hợp thông tin phân tán thay vì dựa vào một bộ gen phát triển ổn định duy nhất.