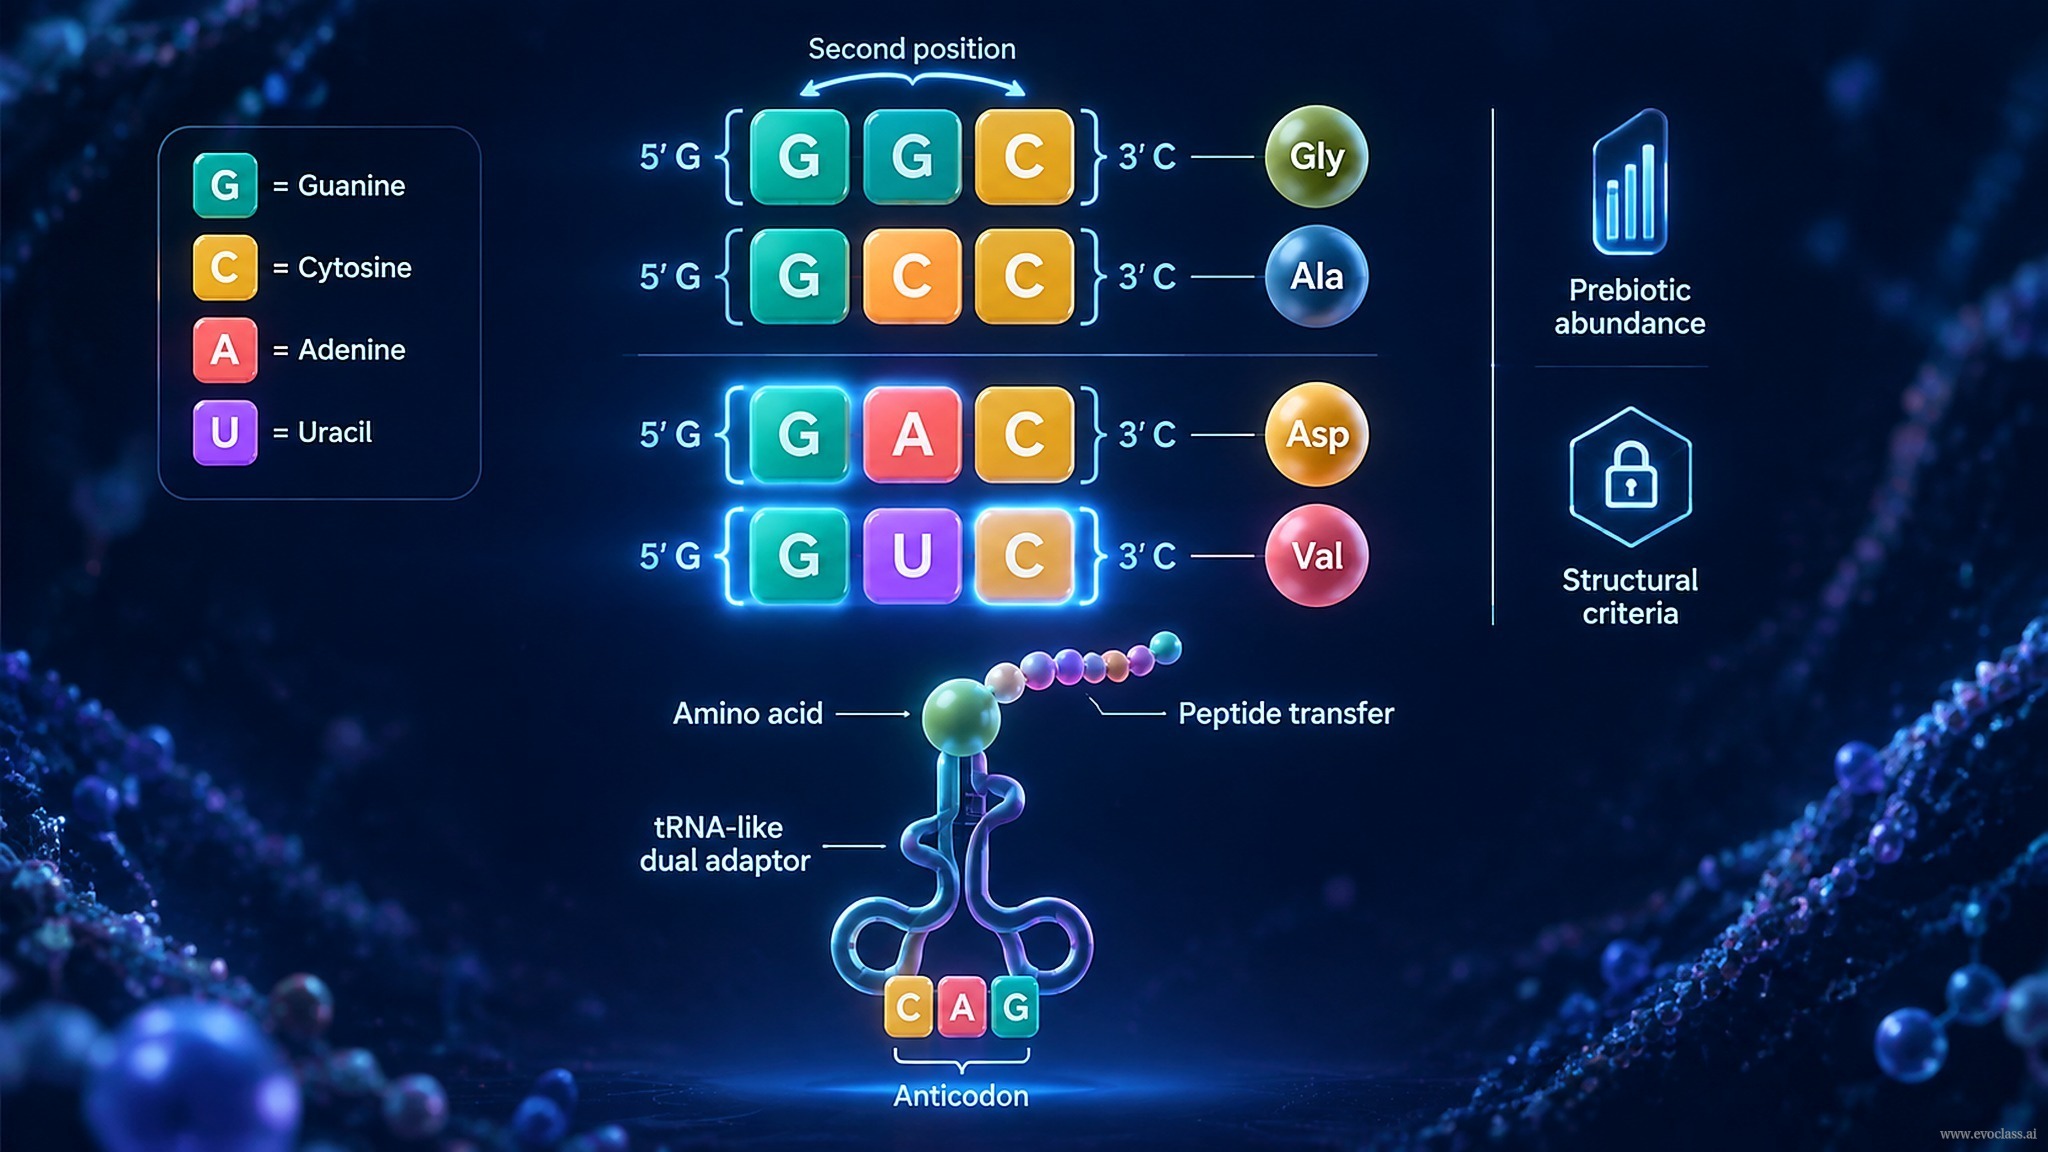
原始遺伝暗号は、2コドンのプロトコードから一次アミノ酸アルファベットへとどのように成長するのでしょうか。このスライドでは、暗号の拡大を 制約された段階的なプロセスとして扱い、完全な64コドン表への突然の跳躍とは見なしません。出発点となるのは、 GGC および GCCのペアです。これらは以前、G–Cに富む複製、高い忠実度、そして一貫したコンマフリー読み枠のために選ばれました。最初の拡張では GAC および GUCが加えられ、 アスパラギン酸(Asp) および バリン(Val) が初期暗号に割り当てられます。標準的には、GGC → Gly、GCC → Ala、GAC → Asp、GUC → Valとなります。
この拡張が組合せ的に単純である理由
初期の4つのコドンはすべて固定枠を共有します: 5′ G ... 3′ C。変化するのは 第2位 のみであり、G、C、A、Uをサンプリングします。これにより簡潔な組合せ経路が得られます。G–C枠とその複製忠実度が確立されれば、1つの位を変えるだけで新たな割り当てを探索できます。したがって、GACとGUCへの拡張は、すでに堅牢な枠組みの中での自然な次の段階です。
一次アルファベットを制限するもの
すべてのアミノ酸が参入できるわけではありません。一次セットは 前生物的存在量 および 構造的基準によって制約されます。すなわち、十分に豊富で適切な側鎖の化学的性質を持ち、RNAアダプター、活性化、ペプチド転移との適合性を備えたアミノ酸のみが暗号に参入できます。翻訳の plausible な起源には、tRNAほどの大きさで二重アダプターおよびメッセンジャーとして機能できる再現性のあるRNA分子、原始的なペプチド転移機構、そして割り当てを維持するのに十分な忠実度も必要です。
ハイパーサイクルとの連成
暗号の拡張は、連成した分子選択の問題です。新しいコドンは、翻訳と連成したハイパーサイクルを改善するか、少なくとも不安定化してはならず、システム全体がエラー閾値の範囲内にとどまる必要があります。このスライドは、最初の2つのコドンから一次アルファベットへの橋渡しです。後期の完全なコドン割り当て表や、翻訳の完全な合成についてはまだ扱いません。
コドン枠の拡張
初期暗号は、GACとGUCを加えることで2コドン(GGC、GCC)から4コドンに拡張されます。4つすべてが固定された5′ Gおよび3′ Cの枠を共有するため、変化するのは第2位のみで、G、C、A、Uをサンプリングします。新しいアミノ酸の参入は、前生物的存在量と構造的基準によってフィルタリングされます。